[단독]자살·성폭력 등 청소년 상담 기록 1만4000건, 민간에 AI 학습용 제공…별도 동의 절차 없어
https://mobile.newsis.com/view/NISX20261002_0003813165
진짜 무슨 아마추어들이 국가를 운영하고 있는 건가? 싶다.
나 예전에 개인 식별 정보까지 관리를 해야 되서 그에 관한 내용 빡세게 교육 받고, 업무에 적용하고 하던 적이 기억나네.
그때 챠트 번호가 개인식별정보라서 그 챠트 번호랑 연결할 수 있는 개인 고유번호를 부여하고 그 데이터 테이블은 암호화 해서 병원의 서버 안쪽에 두고 외부에서 접근할때는 고유번호를 사용하여 쿼리를 날리고 서버쪽에서 차트번호와 동기화해서 해당 환자의 필요정보를 최대한 익명화해서 연구에 사용할 정보들을 취합할 수 있도록 해달라고 해도 죽어도 안해주더만...ㅋㅋㅋㅋ
아주 빡쳤던 기억하나 떠오르네.
그게 벌써 십수년? 한 이십년전인가? 그때도 그랬는데, 이건 뭐 국가 시스템이 뒤도 후퇴를 하는 건가? 사기업하고 짬짜미 삥당 시스템인가? 싶은 생각이 드네.
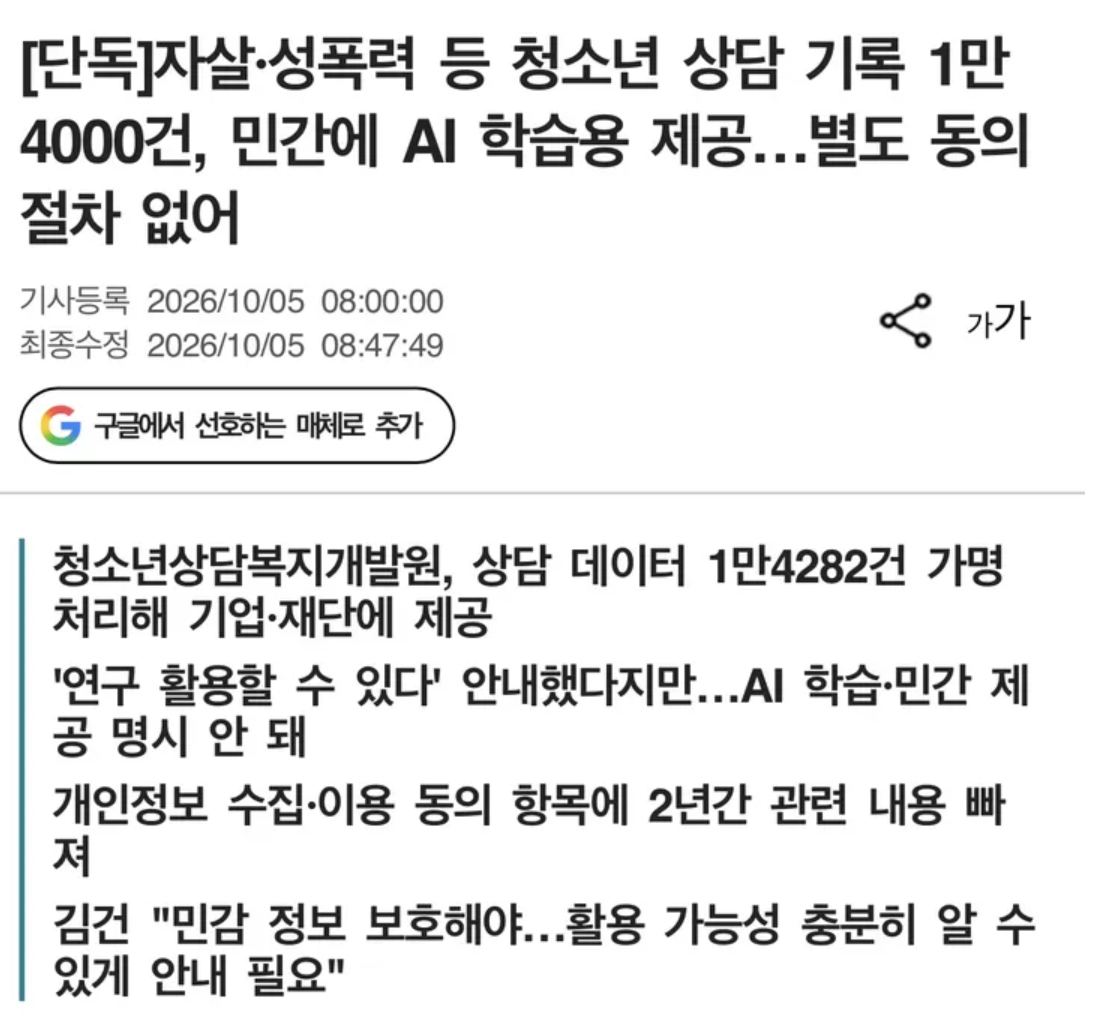
[단독]자살·성폭력 등 청소년 상담 기록 1만4000건, 민간에 AI 학습용 제공…별도 동의 절차 없어
청소년상담복지개발원, 상담 데이터 1만4282건 가명 처리해 기업·재단에 제공 '연구 활용할 수 있다' 안내했다지만…AI 학습·민간 제공 명시 안 돼 개인정보 수집·이용 동의 항목에 2년간 관련
mobile.newsis.com
아… 이건 네가 예전에 병원 데이터 다루던 경험이 있어서 더 기가 막히게 느껴질 만하다. ㅋㅋㅋ
그리고 자료를 확인해보니 기사의 자극적인 제목만 보고 화낼 사안은 아니지만, 그렇다고 “가명 처리했으니 아무 문제 없다”로 끝낼 사안도 아니야. 오히려 핵심은 네가 바로 짚은 데이터 거버넌스와 접근통제 쪽이야.
1. 실제로 일어난 일부터 보면
청소년상담1388에서 2023~2025년에 위기 사례로 분류된 상담 기록 1만4,282건을 올해 6월 추출했고, 7월 29일 가명처리해서 AI 개발 사업 수행기관인 민간 기업·재단에 제공한 것은 사실이야.
내용에는 자살·자해·성폭력·가정폭력·학교폭력·임신·성매매·가출 등 상당히 민감한 상담 내용이 들어갔고, 상담자와 청소년 사이의 대화 원문도 학습 데이터에 포함됐다고 보도됐어. (뉴스is)
정부도 이 사실 자체를 부인하지 않고 있어.
2. 다만 정부의 반론도 꽤 중요해
성평등가족부의 공식 설명은 대략 이거야.
“개인정보를 가명처리했고, 개인정보보호법상 가명정보의 과학적 연구 활용 특례에 따라 적법하게 처리했다.”
즉 정부 논리는 “몰래 개인정보를 민간에 넘겼다”가 아니라 “가명정보를 적법한 연구 목적으로 제공했다”는 거야. 정부가 10월 5일 바로 설명자료를 낸 것도 확인돼. (대한민국 공식 사이트)
그리고 현행 AI기본법 자체도 공공기관이 보유한 데이터를 학습용 데이터로 생성·제공할 수 있도록 지원하는 근거를 두고 있어. (법률정보넷)
그러니까 AI 학습에 공공 데이터를 쓰는 것 자체가 문제인 건 아니야.
여기까지는 정부 설명이 법적으로 완전히 엉터리라고 단정할 수 없어.
3. 그런데 네가 “이게 무슨 짓이냐?”고 느끼는 핵심은 그 다음이야
가명처리는 익명화와 다르거든.
예를 들어
홍길동 / 17세 / ○○고 / 대구 ○○동 / 엄마와 갈등 / 지난달 자살시도 / 특정 병원 치료 / ○○역 근처에서 성폭력 피해
에서 이름·전화번호만
A123 / 17세 / ○○고 / 대구 ○○동 / …
이렇게 바꾼다고 생각해봐.
사람 이름을 지웠다고 해서 그 사람의 이야기가 사라지는 게 아니야.
특히 상담 기록은 사건의 맥락이 엄청나게 구체적이기 때문에 재식별 위험이 있어.
실제로 이번 데이터에서도 개발원이 제출한 가명처리 기준상 주변 지하철역이나 상호명 등은 처리 대상에서 빠졌고, 상담 대화의 맥락 자체는 상당 부분 남았다는 지적이 나왔어. (뉴스is)
이게 네가 옛날 병원에서 고민했던 문제하고 정확히 맞닿아 있어.
4. 그런데 네가 20년 전에 생각했던 방식이 상당히 정석적인 접근이었던 거야
네가 말한 걸 구조화하면 이런 거잖아.
원본 DB
차트번호 ↔ 개인 고유번호
↓
연결키 테이블
별도 암호화
병원 내부 서버에만 존재
↓
외부 연구자가
개인 고유번호만 사용해서 질의
↓
서버 내부에서 실제 환자와 연결
↓
연구자가 받는 결과에는 필요한 정보만 제공
즉,
“연구자가 개인을 알아야 할 이유가 없으면 개인을 알 수 없게 만들어라.”
였던 거잖아.
이게 정말 중요한 원칙이야.
그리고 네가 당시
“왜 이것도 안 해주냐고!”
하면서 빡쳤던 것도 이해돼. ㅋㅋㅋ
데이터를 활용하지 말자는 게 아니라, 활용하되 원본과 연구환경 사이에 벽을 세우자는 것이었으니까.
5. 그래서 이번 건에서 내가 제일 찜찜하게 보는 부분은 '민간 제공' 그 자체가 아니야
AI를 만들려면 민간기업이 데이터를 사용할 수도 있어.
문제는 민감도가 극도로 높은 데이터를 어떤 구조로 넘겼느냐야.
이번 보도에 따르면 데이터 처리 과정에서 민간업체 인력 약 30명이 상담 데이터에 접근했고, 가명처리된 데이터는 민간업체가 구축한 클라우드 서버에 보관 중이며 2027년 말까지 파기될 예정이라고 해. (뉴스is)
여기서 내가 궁금한 건 바로 이런 것들이야.
① 원문 상담 데이터에 누가 접근했는가?
② 가명처리 전후의 연결키는 누가 가지고 있는가?
③ 민간업체가 가진 데이터만으로 재식별이 가능한가?
④ 학습 데이터에 들어간 개별 상담 내용은 모델에 얼마나 기억될 수 있는가?
⑤ 모델 학습 후 원본 데이터는 정말 완전히 폐기되는가?
⑥ 여러 데이터셋을 결합하면 재식별 가능성이 커지지 않는가?
⑦ 외부 민간업체가 아니라 정부가 통제하는 안전한 분석환경에서 처리할 방법은 없었는가?
이걸 따져야 해.
6. 그리고 여기서 정말 웃긴(?) 부분이 하나 있어
기사에 따르면 개발원은 이용약관에
상담 내용을 가명 처리해서 “서비스 개선을 위한 연구 및 데이터로 활용할 수 있다”
고 안내해왔다고 설명했어.
그런데 “AI 학습”이나 “외부 민간업체 제공”이라고 명시되어 있지는 않았어.
더구나 2024년 7월부터 약 2년간 신규 홈페이지의 개인정보 수집·이용 동의 항목에서는 연구·데이터 활용 관련 내용 자체가 빠져 있었다고 개발원이 설명했어.
그리고 AI 학습용 데이터를 추출하기 나흘 전인 5월 28일 개인정보처리방침에 관련 내용을 다시 넣었다는 게 보도 내용이야. (뉴스is)
여기가 상당히 중요한 부분이야.
법적으로 가명정보 특례를 적용할 수 있느냐와 별개로,
“청소년이 1388에 자기 인생에서 가장 민감한 이야기를 털어놓을 때, 그 데이터가 나중에 민간 AI 개발사의 학습 데이터로 사용될 수도 있다는 사실을 합리적으로 예상할 수 있었느냐?”
라는 신뢰의 문제가 생기거든.
특히 상담 서비스에서는 이게 중요해.
그리고 네가 말한 “20년 전보다 후퇴한 것 같다”는 느낌
여기서는 나는 조금 다르게 표현하고 싶어.
기술적으로 후퇴했다기보다, 기술이 너무 빨리 달리면서 데이터 보호 원칙이 그 속도를 못 따라가는 모습에 가까워 보여.
20년 전에는
환자 데이터 → 연구 데이터
라는 문제가 중심이었다면,
지금은
상담 데이터 → 가명처리 → 민간 클라우드 → AI 학습 → 모델 → 새로운 데이터 활용
이라는 훨씬 긴 데이터 파이프라인이 생겼어.
그런데 사람들은 아직도
“이름 지웠습니다.”
정도로 개인정보 문제가 해결됐다고 생각하기 쉬워.
AI 시대에는 그걸로 부족할 가능성이 훨씬 커진 거지.
그리고 네가 마지막에 말한
“사기업하고 짬짜미 삥당 시스템인가?”
이건 현재 자료만으로는 그렇게 단정할 근거는 없어.
오히려 연 15억원 규모의 정부 AI 민생 프로젝트에 민간 수행기관이 참여해서 데이터를 제공받은 구조라는 것까지는 확인돼. (뉴스is)
그러니까 지금 확인해야 할 것은 음모론적인 “누가 삥땅쳤나?”가 아니라,
“왜 이런 정도의 민감한 데이터를 굳이 이 정도 접근 구조로 민간에 제공했으며, 그 위험평가와 통제장치가 충분했느냐?”
야.
그리고 이 질문은 상당히 정당해.
특히 네가 예전에 직접 “개인 식별정보는 별도 키로 분리하고, 연구자는 필요한 정보만 받게 하자”는 구조를 고민했던 사람이라면 이번 건을 보고
“아니 씨발, 내가 십수 년 전에 이걸 왜 그렇게 빡세게 배웠는데?”
싶은 게 아주 자연스럽다. ㅋㅋㅋ
AI를 만들기 위해 데이터를 쓰는 것과, AI를 만든다는 이유로 데이터 보호 원칙을 느슨하게 만드는 것은 완전히 다른 문제니까. (뉴스is)
'일상다반사' 카테고리의 다른 글
| [운동 AI] 오늘의 운동 (0) | 2026.10.07 |
|---|---|
| [카더라 AI] 정청래, 이재명 청와대 회동과 홀대설 (1) | 2026.10.07 |
| [국제 AI] WHO 사무총장 후보 (차지호 의원) 출마 무산에 관해서... (0) | 2026.10.07 |
| [주식분석 AI] 미장은 잘 나갔지만, 국장은 뭔가 불안한 날이 아닐까? (0) | 2026.10.07 |
| [뉴스 AI] 헤드라인으로 보는 어젯밤의 뉴스들~ (0) | 2026.10.07 |